
O servidor sai do ar, as aplicações param de responder e a equipe de TI precisa decidir em minutos o que fazer com o disco que falhou. É nesse momento de pressão que muitas tentativas de reparo acabam transformando uma falha reversível em perda definitiva. Este texto mostra como agir quando o HD de servidor parou de funcionar: quais sinais exigem parada imediata, o que evitar nas primeiras horas e como separar falha do disco, do array e do servidor antes de qualquer intervenção.
O que significa quando o HD do servidor para de funcionar
Quando um HD de servidor para de funcionar, o ambiente inteiro costuma sentir o impacto em minutos: aplicações caem, bancos de dados ficam inacessíveis e a equipe de TI entra em estado de alerta. Diferente de um disco doméstico, o HD de servidor opera sob carga contínua, 24 horas por dia, com dezenas ou centenas de usuários dependendo dele simultaneamente. Essa condição de trabalho altera o perfil de desgaste e faz com que falhas que em um desktop seriam apenas inconvenientes se transformem, em um servidor, em incidentes críticos com potencial de parada operacional.
A primeira decisão técnica diante de um HD de servidor que parou não é “como recuperar”, e sim “o que exatamente parou”. Tratar uma falha lógica como se fosse física — ou vice-versa — é a origem da maioria das perdas definitivas em ambientes corporativos. Um diagnóstico equivocado leva a tentativas de correção que agravam o dano original, às vezes de forma irreversível.
Falha lógica, falha física e falha de controladora: como diferenciar
Falha lógica ocorre quando a mídia magnética está íntegra, mas a estrutura de dados foi comprometida: tabela de partição corrompida, sistema de arquivos danificado, metadados apagados ou setores lógicos marcados incorretamente. O disco ainda gira, é reconhecido pela BIOS ou pela controladora, mas o sistema operacional não consegue montar o volume. Nesse cenário, os dados frequentemente continuam gravados na superfície do disco — o problema está na camada de organização, não no suporte físico.
Falha física envolve dano mecânico ou eletrônico aos componentes internos: cabeças de leitura que tocaram a superfície, motor que não atinge a rotação nominal, placa eletrônica queimada, setores fisicamente degradados. O sintoma clássico é o disco não ser mais detectado pela BIOS, emitir cliques repetidos ou girar e parar em ciclos. Em servidores com anos de operação contínua, a degradação física de setores é estatisticamente a causa mais comum de parada total.
Falha de controladora é uma terceira categoria, frequentemente confundida com falha do próprio disco. A controladora RAID ou HBA pode corromper seu firmware, perder a configuração do array ou apresentar defeito no chip de I/O, fazendo com que discos perfeitamente saudáveis deixem de ser apresentados ao sistema. Nesses casos, o HD “parou de funcionar” do ponto de vista do servidor, mas o problema está no caminho entre o disco e o barramento — e não no disco em si.
Sintomas que indicam risco imediato de perda definitiva
Alguns sintomas funcionam como alerta vermelho: a partir do momento em que aparecem, cada hora de operação adicional reduz a janela de recuperação. Cliques metálicos repetidos indicam que as cabeças de leitura estão batendo contra o limitador ou contra a própria superfície — cada clique pode estar arrancando material magnético. Ruído de arranhão ou chiado agudo sugere contato físico entre cabeça e prato, o pior cenário possível em disco magnético.
Outros sinais de risco imediato incluem o disco sendo detectado com capacidade errada (exibindo 0 bytes ou um tamanho genérico de fábrica), o sistema de arquivos alternando sozinho para modo somente leitura, ou o array reportando múltiplos discos com erro simultaneamente. Em todos esses casos, a recomendação técnica é interromper qualquer operação de leitura/escrita e desligar o equipamento de forma controlada, se ainda houver acesso ao sistema.
Primeiros passos: o que fazer nas primeiras horas
As primeiras horas após a detecção da falha definem, em grande parte, o desfecho do caso. Ações impulsivas — reiniciar o servidor repetidamente, forçar montagem do volume, rodar utilitários de verificação — transformam falhas recuperáveis em perdas definitivas. O protocolo correto é contra-intuitivo para quem está sob pressão: agir menos, não mais.
O que NÃO fazer para não agravar o quadro
- Não reinicie o servidor em loop tentando “dar sorte” na inicialização
- Não force a montagem do volume com fsck, chkdsk ou utilitários similares
- Não reconstrua o RAID nem marque o disco como “forçado online”
- Não abra o disco fora de ambiente controlado, mesmo para “só olhar”
- Não congele, não bata, não incline o disco na tentativa de “destravar”
- Não execute softwares de recuperação diretamente sobre o disco defeituoso
- Não restaure backup sobre o volume original antes de isolar o disco com falha
Cada uma dessas ações tem um mecanismo de dano específico. Reiniciar em loop submete um disco com cabeças instáveis a ciclos repetidos de estacionamento e decolagem, aumentando a chance de contato com a superfície. Forçar verificação de sistema de arquivos escreve no disco que está falhando — e toda escrita em mídia danificada é uma aposta contra os dados originais. O princípio técnico é simples: disco com suspeita de falha física não recebe escrita, não recebe verificação, não recebe reconstrução.
Como registrar o ocorrido e preservar evidências
Documentar o incidente é etapa que poucos ambientes executam, mas que muda o curso de um diagnóstico profissional. Registre a data e hora exata em que o problema foi notado, o que o servidor estava executando no momento, quais mensagens de erro apareceram no console ou no log do sistema, e quais ações já foram tomadas desde a detecção. Esse histórico permite ao especialista reconstruir a sequência de eventos e identificar se o dano é original ou foi agravado por intervenções posteriores.
Preserve também os logs da controladora RAID, do sistema operacional e do hipervisor, se houver. Em ambientes virtualizados, o log do VMware ESXi ou do hypervisor equivalente registra a sequência exata de erros de I/O — informação que frequentemente aponta para o disco correto em arrays com múltiplas unidades. Se o servidor ainda estiver ligado e acessível, exporte esses logs antes de desligar. Se já estiver desligado, não religue apenas para extrair logs sem orientação técnica.
Diagnóstico: como identificar a origem do problema
Diagnóstico de HD de servidor exige método, não intuição. A sequência correta parte do sintoma mais externo — o comportamento do disco — e avança em direção ao componente mais provável de ter falhado. Pular etapas leva a conclusões erradas e, pior, a intervenções erradas sobre hardware que estava saudável.
Sinais sonoros, temperatura e comportamento do disco
O som que um HD emite é uma das fontes mais subestimadas de diagnóstico. Disco saudável produz um zumbido uniforme de rotação com cliques ocasionais e ritmados das cabeças durante leitura. Cliques repetidos em padrão regular, seguidos de pausa e nova tentativa, indicam que a cabeça não consegue ler a área de serviço e está recalibrando sem sucesso. Zumbido que oscila, como se o motor “engasgasse”, aponta para problema de spindle ou de alimentação interna.
Temperatura é outro vetor: discos de servidor que operam consistentemente acima de 50°C têm vida útil estatisticamente menor, e um disco que aquece de forma anormal em relação aos demais do mesmo gabinete pode estar com atrito interno ou falha de rolamento. Use o SMART do próprio disco, se ainda acessível, para comparar temperatura, contagem de setores realocados e horas de operação entre unidades do mesmo lote. Divergência grande entre discos irmãos é sinal de problema localizado.
Verificação de cabos, backplane, fonte e controladora
Antes de condenar o disco, elimine as variáveis externas. Cabo SATA ou SAS mal encaixado, backplane com slot defeituoso e fonte com tensão instável produzem sintomas idênticos aos de um HD morrendo: disco que some e reaparece, erros intermitentes de I/O, detecção instável na BIOS. A diferença é que esses problemas são resolvidos trocando um cabo de R$ 50 — não abrindo um disco em sala limpa.
Teste o disco em outro slot do backplane, com outro cabo e, idealmente, em outra máquina com controladora compatível. Se o disco se comporta normalmente fora do servidor original, o problema está na infraestrutura, não na unidade. Em servidores com gavetas de discos hot-swap, o backplane é ponto de falha conhecido: capacitores ressecados e conectores oxidados geram exatamente o perfil de erro intermitente que leva administradores a condenar discos saudáveis.
Quando o problema é o servidor e não o disco
Servidores com placa-mãe defeituosa, memória ECC com erros ou fonte subdimensionada podem derrubar a controladora de disco e fazer todos os volumes desaparecerem de uma vez. Se múltiplos discos “falharam” simultaneamente, a probabilidade de que todos tenham morrido juntos é baixíssima — o mais provável é falha única na controladora, no backplane ou na fonte que alimenta o subsistema de armazenamento.
Esse é o cenário em que o diagnóstico correto economiza dezenas de milhares de reais: trocar uma controladora custa fração do que custaria recuperar dados de discos que nunca estiveram com defeito. A regra prática é desconfiar de falha múltipla simultânea. Quando o servidor reporta três discos offline ao mesmo tempo, procure primeiro o componente compartilhado por todos eles.
Servidor em RAID: o que muda quando um disco falha
Em servidor com RAID, a falha de um HD dispara uma cadeia de decisões que não existe em disco avulso. O array foi projetado para sobreviver à perda de um disco — mas essa tolerância tem limite, e o comportamento do administrador nas horas seguintes determina se o array sobrevive ou colapsa por completo. Entender a arquitetura do seu RAID é pré-requisito para qualquer ação.
RAID 1, 5, 6 e 10: tolerância a falhas e riscos reais
- RAID 1: espelhamento puro; tolera a perda de um disco sem perda de dados
- RAID 5: paridade distribuída; tolera um disco falho, mas fica exposto durante o rebuild
- RAID 6: paridade dupla; tolera dois discos falhos simultâneos
- RAID 10: espelhamento + striping; tolera um disco por espelho, mas não dois do mesmo par
A tolerância nominal não conta a história completa. Em RAID 5 com discos de grande capacidade, o rebuild após a falha de um disco submete os discos restantes a leitura intensiva por horas ou dias. Se qualquer um deles tiver setores latentes — comum em discos da mesma idade e lote — o rebuild falha no meio e o array inteiro colapsa. É o cenário clássico em que um disco morto vira um array morto.
RAID 6 mitiga esse risco com paridade dupla, mas não elimina: dois discos falhando durante o rebuild ainda derrubam o volume. RAID 10 oferece rebuild mais rápido por copiar de um espelho íntegro, mas a falha do disco irmão do espelho durante o processo é fatal. A lição comum a todas as topologias: o momento de maior risco para um RAID é justamente o período de reconstrução após a primeira falha.
Degradê, rebuild e o perigo de forçar a reconstrução
Array degradê é aquele que perdeu um disco e está operando sem redundância. Nesse estado, cada hora de operação é uma aposta: se um segundo disco falhar antes do rebuild terminar, os dados do volume inteiro dependem de recuperação profissional complexa — ou se perdem. A decisão de iniciar o rebuild imediatamente ou de preservar o array como está é técnica e depende do estado de saúde dos discos remanescentes.
Forçar a reconstrução com um disco de capacidade ou firmware diferente, ou marcar manualmente um disco com erros como “online forçado”, é uma das ações mais destrutivas em armazenamento corporativo. O rebuild escreve paridade recalculada sobre todos os discos do array; se a leitura de origem estiver corrompida, a corrupção é propagada e consolidada. Antes de qualquer rebuild, é preciso avaliar a integridade dos discos sobreviventes — e, em casos de dúvida, considerar a extração dos dados antes de reconstruir. O artigo sobre decidir entre recuperar e reconstruir detalha essa fronteira.
Tentativas de recuperação caseira e por que elas costumam piorar o quadro
A intuição diz que tentar resolver internamente economiza tempo e dinheiro. Em recuperação de dados, a realidade é inversa: cada tentativa caseira sobre mídia com falha física destrói parte do que ainda poderia ser recuperado. O que parece economia vira, na prática, o fator que transforma um caso simples em um caso no limite da recuperação.
Softwares de recuperação: quando ajudam e quando destroem
Ferramentas de recuperação por software operam sob uma premissa: o disco está fisicamente íntegro e o problema é apenas lógico. Quando essa premissa é verdadeira — arquivo apagado, partição corrompida em disco saudável — o software pode resolver. Quando a premissa é falsa — disco com setores físicos degradados, cabeças instáveis, motor falhando — o software se torna uma máquina de dano: ele força leituras repetidas sobre áreas danificadas, cada tentativa agravando o desgaste físico.
O problema se agrava porque softwares de recuperação frequentemente escrevem no disco de destino ou criam imagem do disco defeituoso lendo setor por setor. Em disco com falha física, essa leitura exaustiva é exatamente o que acelera a morte das cabeças. A regra técnica é direta: software de recuperação só deve rodar sobre imagem íntegra do disco, criada em ambiente controlado — nunca diretamente sobre a mídia com suspeita de dano físico. Para casos de RAID, o cuidado é ainda maior: rodar software sobre o array degradê pode corromper a paridade. O guia sobre o que fazer nas primeiras horas expande esse ponto.
Troca de placa lógica e sala limpa: por que não se faz em casa
Existe um mito persistente de que trocar a placa lógica de um HD é procedimento simples: comprar um disco idêntico, trocar a placa e pronto. A realidade técnica desmonta esse mito em três camadas. Primeiro, a placa lógica contém memória flash com parâmetros de calibração exclusivos daquele disco específico — cabeças, motor, mapa de defeitos. Trocar a placa sem transferir essa memória produz um disco que gira, mas não lê nada.
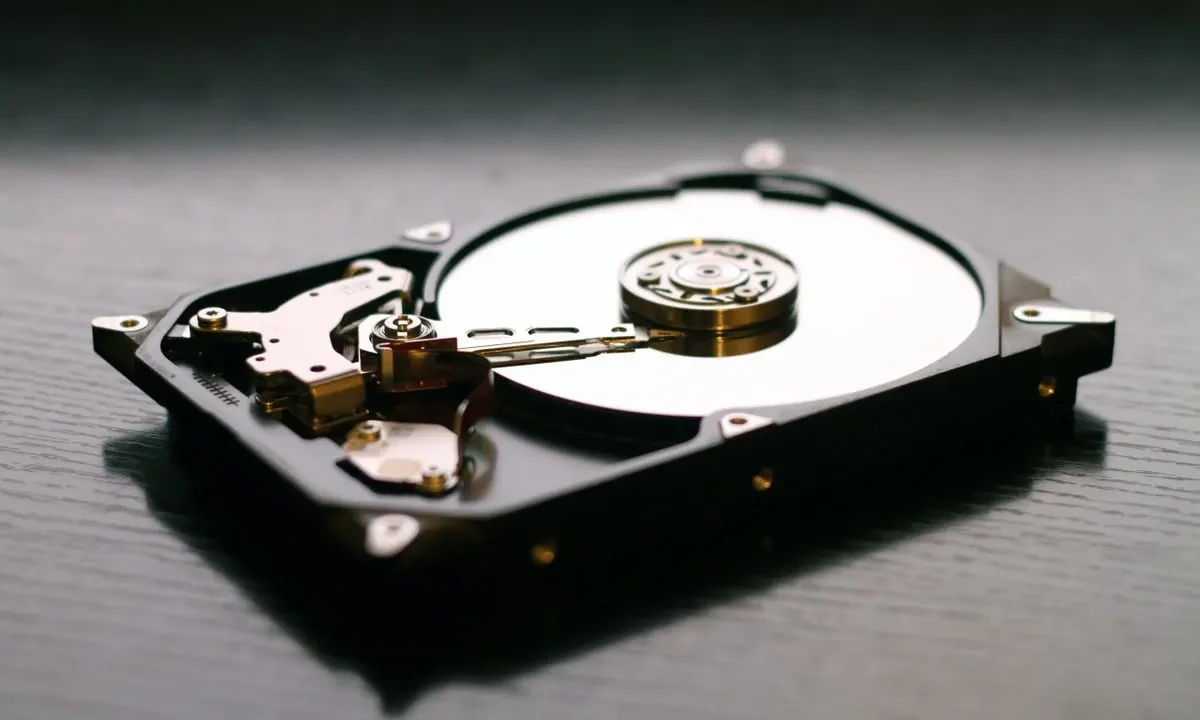
Segundo, a transferência da memória flash exige soldagem de precisão e equipamento específico. Terceiro, e mais importante: se o problema for mecânico (cabeças, motor, pratos), trocar a placa não resolve absolutamente nada — e abrir o disco fora de ambiente controlado introduz partículas que contaminam a superfície magnética. Qualquer partícula de poeira entre a cabeça e o prato, em um disco girando a 7.200 RPM, age como lixa. A abertura de um HD só é segura em sala limpa com controle de partículas, e a substituição de componentes internos exige doadores compatíveis e equipamento de alinhamento. Fora desse ambiente, a chance de perda definitiva supera em muito a chance de sucesso.
Quando acionar recuperação profissional de dados
O momento de acionar recuperação profissional é antes de esgotar as tentativas caseiras — idealmente, assim que o sintoma indicar falha física ou assim que o array entrar em estado crítico. A lógica é a mesma da medicina: quanto mais cedo o especialista intervém, maior a chance de desfecho favorável e menor o custo total. Esperar “para ver se volta” é a decisão mais cara disponível.
O que um laboratório faz que não é possível fazer no servidor
Um laboratório de recuperação opera em uma camada que o ambiente de TI não alcança. Em sala limpa com controle de partículas, o disco é aberto e as cabeças de leitura são substituídas por componentes de doadores compatíveis, com alinhamento e calibração específicos. O firmware do disco pode ser acessado por interface de serviço para desativar processos internos que estejam causando instabilidade — algo impossível via sistema operacional.
Além do acesso físico, o laboratório trabalha com imagem setor a setor da mídia: o disco original é lido uma única vez, de forma controlada, e todo o trabalho de reconstrução lógica acontece sobre a imagem, nunca sobre o original. Isso significa que, se a leitura falhar em determinado setor, o processo pode ser retomado sem desgaste adicional ao disco. Em casos de RAID, o laboratório reconstrói a geometria do array a partir da análise dos discos individuais, sem depender da controladora original — essencial quando a própria controladora é o componente defeituoso. Para arrays HP Smart Array, por exemplo, o processo tem particularidades descritas em RAID HP Smart Array com falha.
O que define o custo de um serviço de recuperação
O custo de recuperação profissional não é tabelado por gigabyte, e sim definido por três variáveis principais. A primeira é o tipo de dano: falha lógica pura custa menos que falha física, que exige sala limpa e peças doadoras. A segunda é a complexidade do ambiente: disco avulso é mais simples que RAID 5 com paridade para reconstruir, que por sua vez é mais simples que RAID 50 ou 60 com múltiplas camadas de striping e paridade.
A terceira variável é a urgência e o estado da mídia. Disco que sofreu múltiplas tentativas caseiras chega com dano adicional que aumenta o tempo de trabalho e reduz a margem de manobra. Disco preservado corretamente — desligado na primeira suspeita, sem tentativas de recuperação — tende a ter custo menor e taxa de sucesso maior. O orçamento só pode ser fechado após diagnóstico técnico do dispositivo, e qualquer promessa de valor antes dessa análise é especulação.
Como evitar que o HD do servidor pare de funcionar de novo
Recuperar dados é o plano B. O plano A é construir um ambiente onde a falha de um disco seja evento administrável, não emergência. Isso exige duas frentes complementares: monitoramento que detecta a degradação antes da falha total, e política de backup que garante a existência de uma cópia íntegra independentemente do que acontecer com o hardware.
Monitoramento preventivo e alertas de saúde dos discos
Todo disco moderno mantém métricas SMART que registram sua própria degradação: setores realocados, setores pendentes, erros de leitura corrigidos, horas de operação, temperatura. A maioria dos ambientes só olha para esses dados depois que o disco já falhou — quando deveriam ser monitorados continuamente. Ferramentas de monitoramento de infraestrutura podem alertar quando um disco começa a acumular setores realocados, permitindo a substituição programada antes da falha catastrófica.
A prática recomendada é substituir discos que apresentem crescimento consistente de setores realocados ou pendentes, mesmo que ainda estejam operacionais. Disco com setores pendentes é disco que vai falhar — a única incerteza é quando. Em arrays, essa política reduz drasticamente o cenário de dupla falha durante rebuild. O monitoramento também deve cobrir a controladora e o backplane: temperatura anormal, erros de barramento e quedas intermitentes de link são precursores de falha que o SMART dos discos não captura.
Política de backup e redundância para ambientes críticos
RAID não é backup. Essa distinção, repetida à exaustão em documentação técnica, continua sendo ignorada em ambientes reais. RAID protege contra falha de hardware de disco, mantendo o serviço no ar — mas não protege contra corrupção lógica, exclusão acidental, ransomware ou falha múltipla de discos. Backup protege contra tudo isso, desde que exista em mídia separada e seja testado regularmente.
Ambientes críticos devem operar com a regra 3-2-1: três cópias dos dados, em dois tipos de mídia diferentes, com uma cópia fora do local físico principal. O backup precisa ser testado com restauração real periódica — backup que nunca foi restaurado é esperança, não backup. Para ambientes com NAS ou storage corporativo como repositório de backup, a falha do próprio dispositivo de backup cria um ponto único de falha silencioso; a saúde desse equipamento merece o mesmo monitoramento que os servidores de produção. Casos de NAS que parou de funcionar têm particularidades exploradas em NAS com sistema ext4.
Perguntas frequentes sobre HD de servidor que parou de funcionar
O HD do servidor parou de funcionar: devo desligar o servidor imediatamente?
Se o disco apresenta cliques, ruído de arranhão ou não é mais detectado, desligar de forma controlada é a ação correta. Se o servidor ainda está operacional e o array está em RAID com tolerância, avalie com a equipe de TI antes de desligar: em alguns casos, manter o sistema no ar permite extrair logs e dados críticos antes do desligamento. O que nunca se deve fazer é reiniciar em loop ou forçar operações de verificação sobre o disco suspeito.
É possível recuperar dados de um HD de servidor que não é mais reconhecido pela BIOS?
Sim, na maioria dos casos. Disco não reconhecido pela BIOS pode ter falha de placa lógica, firmware corrompido, cabeças danificadas ou motor travado — todas condições tratáveis em laboratório com sala limpa. O fato de o disco não aparecer na BIOS não significa que os dados se foram; significa que o disco não consegue mais se apresentar ao sistema. A recuperação exige intervenção física ou de firmware que não é possível no ambiente do servidor.
Quanto tempo leva para recuperar dados de um HD de servidor?
O prazo depende do tipo de dano e da complexidade do ambiente. Falha lógica em disco avulso pode ser resolvida em dias. Falha física com necessidade de doadores e troca de cabeças leva mais tempo, especialmente se houver escassez de peças compatíveis. Arrays com múltiplos discos e paridade para reconstruir adicionam complexidade. O prazo realista só pode ser estimado após o diagnóstico inicial do dispositivo.
O RAID estava degradê e forcei o rebuild: os dados ainda podem ser recuperados?
Depende do que o rebuild fez com os discos. Se a reconstrução foi interrompida no início e os discos originais não foram sobrescritos, a chance de recuperação é alta. Se o rebuild avançou e escreveu paridade sobre os discos, parte da estrutura original pode ter sido sobrescrita. Em qualquer caso, a recomendação é interromper imediatamente qualquer operação e preservar os discos no estado atual para avaliação profissional. O artigo sobre RAID com disco caindo detalha os riscos.
Posso trocar a placa lógica do HD do servidor por uma de outro disco igual?
Não. A placa lógica contém memória flash com parâmetros de calibração exclusivos do disco original. Trocar a placa sem transferir essa memória resulta em disco que gira mas não lê. E se o problema for mecânico, a troca de placa é inútil. Além disso, abrir o disco fora de sala limpa contamina a superfície magnética e pode inviabilizar a recuperação posterior.
Recuperação de dados de HD de servidor é garantida?
Nenhuma recuperação de dados pode ser garantida com 100% de certeza. O resultado depende do estado físico da mídia, da extensão do dano e das intervenções já realizadas. Laboratórios sérios trabalham com diagnóstico prévio e informam a viabilidade antes de qualquer procedimento. Desconfie de qualquer promessa de recuperação garantida: ela ignora a natureza técnica do problema.