O alarme chega pelo vSphere: o datastore inacessível aparece no inventário e o time de TI precisa decidir, sob pressão, se espera o caminho voltar, mexe na configuração ou para tudo. Cada comando executado sem critério pode transformar uma falha reversível em perda definitiva. Este texto organiza o diagnóstico por camada, mostra o que evitar antes de coletar evidências e ajuda a identificar quando o caso já exige recuperação especializada em laboratório.
Datastore inacessível no VMware: o que o erro significa de fato
Um datastore inacessível no VMware significa que o ESXi perdeu a capacidade de ler ou gravar no volume de armazenamento onde ficam os arquivos das máquinas virtuais. A VM pode continuar ligada em memória, mas qualquer operação de disco falha, e o estado do ambiente se torna crítico. A causa pode estar no caminho de rede, no storage array, no RAID, nos metadados do VMFS ou em uma combinação dessas camadas. Antes de qualquer ação, é preciso identificar se a perda é temporária ou permanente, porque a reação correta muda completamente.
O erro aparece no vSphere como “inaccessible” ao lado do nome do datastore, e os hosts deixam de enxergar o volume. Isso não significa, por si só, que os dados foram perdidos. Em muitos casos, o volume volta sozinho quando o caminho é restabelecido. Em outros, a estrutura lógica do VMFS foi danificada e exige recuperação especializada. A ordem das ações importa mais do que a velocidade: mexer no lugar errado pode transformar uma falha reversível em perda permanente.
Precisa recuperar seus dados?
Laboratório próprio e atendimento emergencial. Chame no WhatsApp e receba o diagnóstico.
Recuperar meus dadosAPD e PDL: duas falhas diferentes que exigem reações diferentes
O vSphere classifica a perda de acesso a um datastore em dois eventos distintos: APD (All Paths Down) e PDL (Permanent Device Loss). A diferença não é burocrática. Ela define se você deve esperar, agir no vSphere ou partir para recuperação. Tratar um PDL como APD, ou o contrário, é uma das causas mais comuns de agravamento do problema.
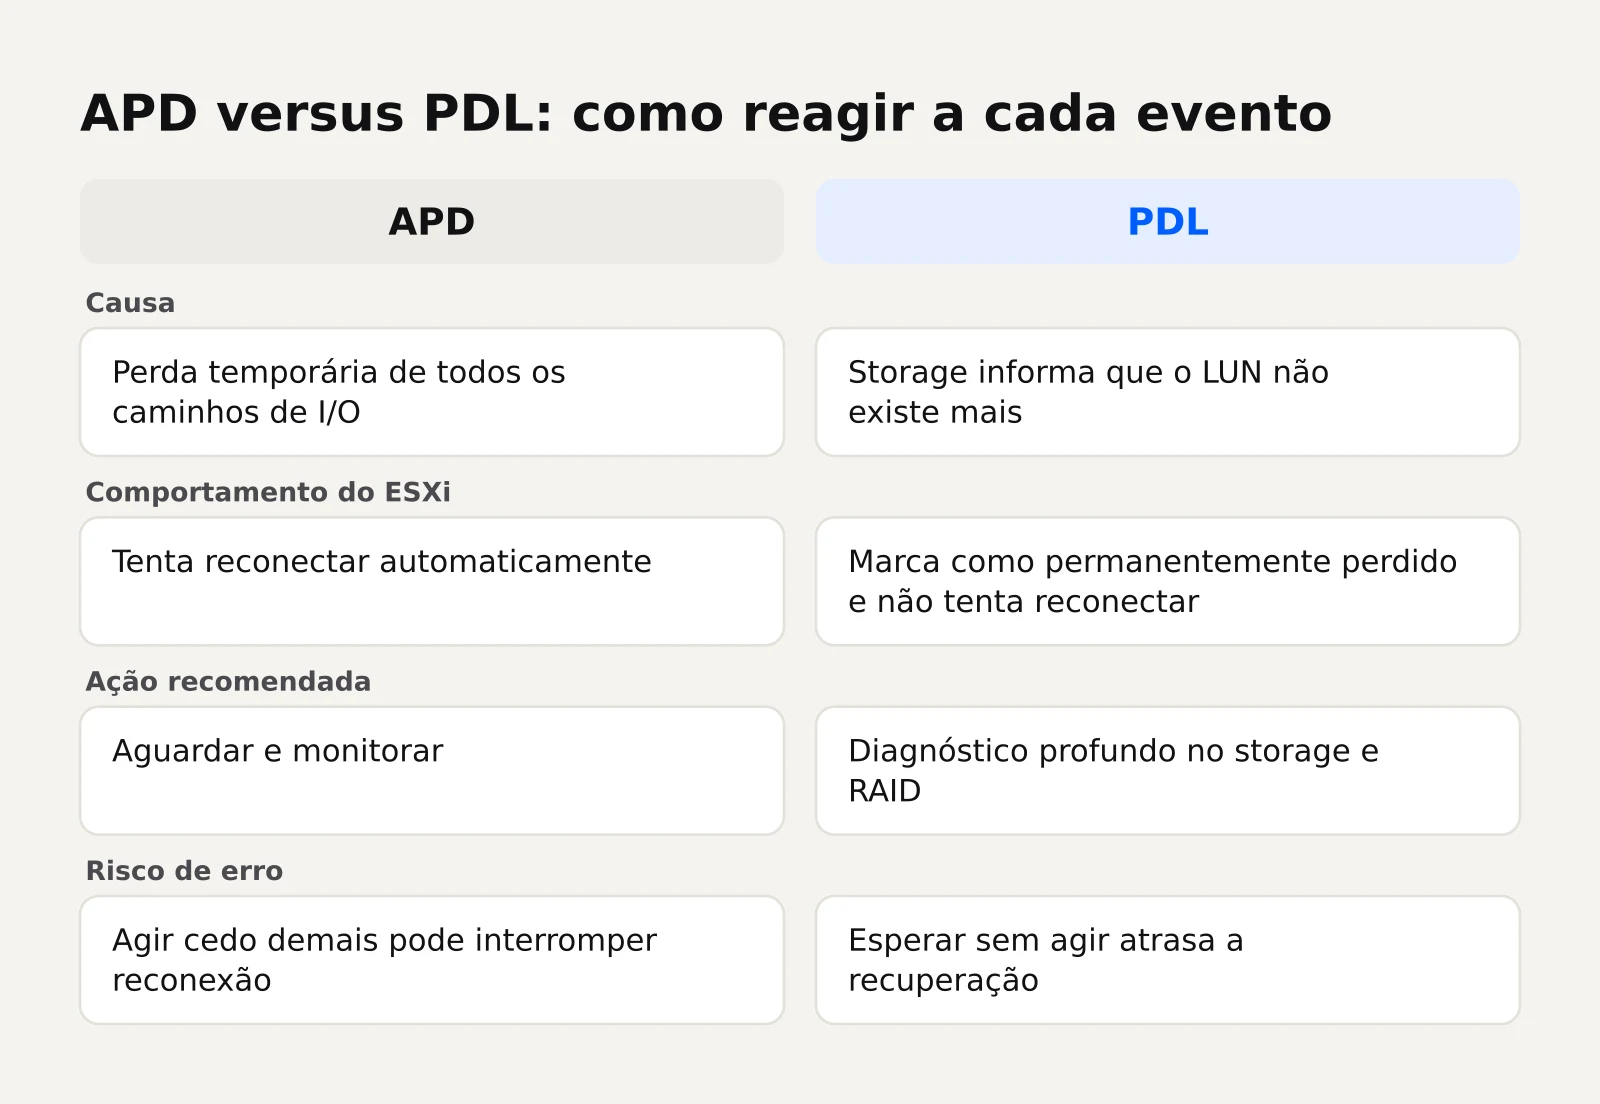
Imagine um datastore que some por alguns segundos durante uma oscilação na rede de storage. O ESXi marca APD e fica tentando reestabelecer o caminho. Por isso, o primeiro passo é sempre classificar o evento corretamente.
All Paths Down: perda temporária de caminho
APD ocorre quando todos os caminhos de I/O para o dispositivo ficam indisponíveis por um período, mas o storage em si continua existindo. É o cenário típico de falha em switch Fibre Channel, controladora com reinício breve, cabo desconectado ou interrupção de rede iSCSI. O datastore some do mapa de storage, mas o volume ainda está lá, íntegro, esperando o caminho voltar.
A reação recomendada é aguardar e monitorar. O ESXi tenta reconectar sozinho. Se o caminho voltar, o datastore reaparece e as VMs retomam a operação. O tempo de espera depende da criticidade do ambiente, mas a paciência aqui é uma ferramenta de proteção de dados.
Permanent Device Loss: quando o storage não volta
PDL é o evento em que o dispositivo informa ao ESXi, por meio do SCSI sense code, que o volume não existe mais ou não será mais apresentado. Não é uma queda de caminho: é a confirmação do storage de que aquele LUN foi removido, mapeado incorretamente ou destruído. O ESXi marca o datastore como permanentemente perdido e não tenta reconectar.
Nesse cenário, esperar não resolve. O volume não vai “voltar sozinho” porque o array já declarou que ele não existe. A ação passa a ser de diagnóstico profundo: verificar se o LUN foi desmapeado por erro de configuração, se o RAID subjacente degradou a ponto de derrubar o volume, ou se houve falha física. Se o LUN foi recriado por engano, a recuperação dos metadados do VMFS vira prioridade.
Primeiras ações seguras antes de qualquer tentativa de correção
O instinto de “fazer alguma coisa” é o maior inimigo nesse cenário. As primeiras ações devem ser de coleta de evidências e preservação do estado, não de correção. Cada comando executado no vSphere ou no storage pode sobrescrever informações que seriam essenciais para uma recuperação posterior. A regra é simples: primeiro entenda, depois aja.
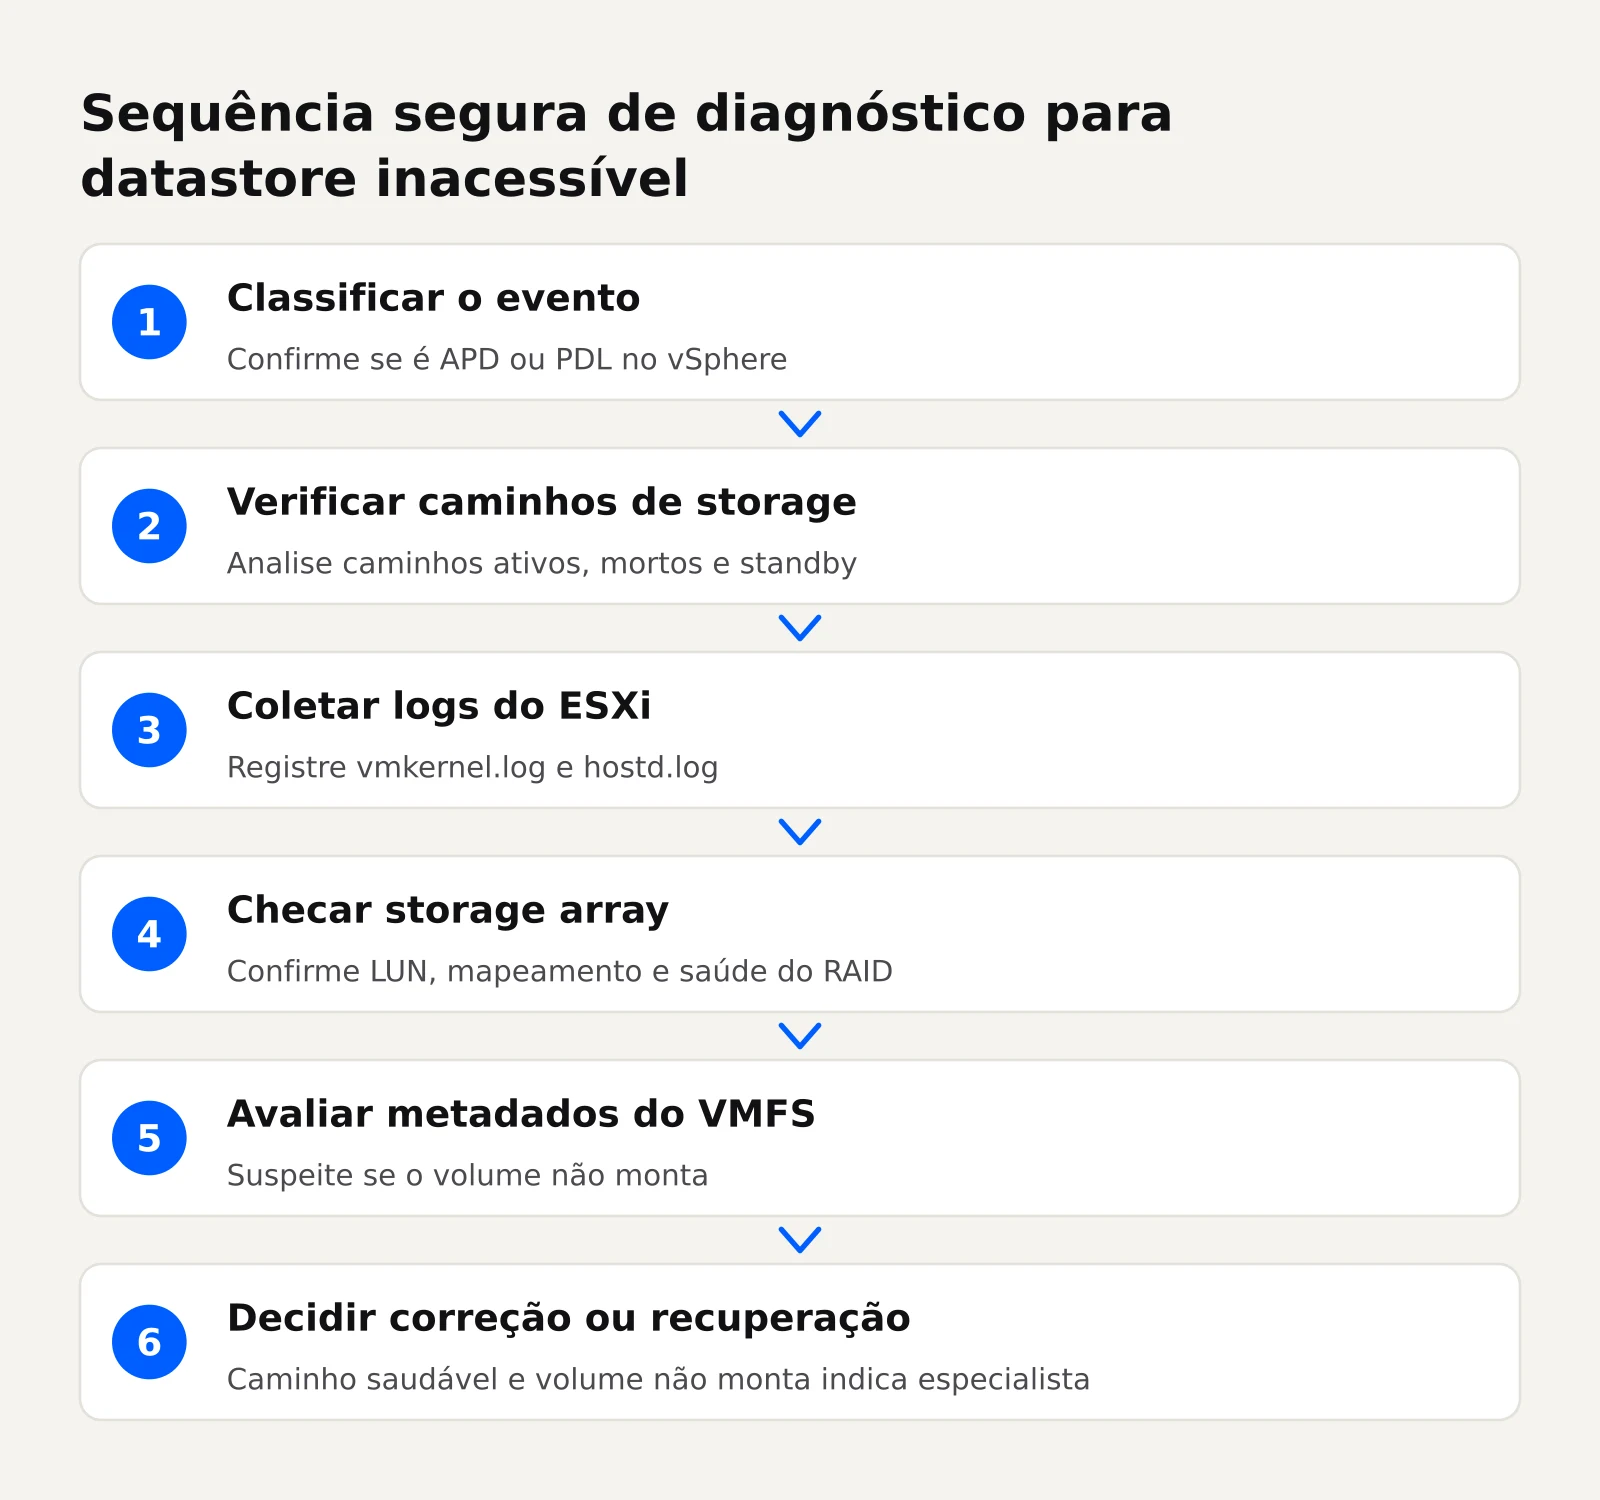
O que verificar sem alterar o estado do datastore
- Estado do evento no vSphere: confirme se o datastore está marcado como APD ou PDL no log e no inventário.
- Caminhos de storage: veja quantos caminhos estão ativos, mortos ou em standby para aquele LUN.
- Logs do ESXi: os arquivos
vmkernel.logehostd.logregistram o momento exato da perda e os sense codes retornados pelo storage. - Visão do array: no gerenciamento do storage, confirme se o LUN ainda existe, se está mapeado para o host e se o RAID está saudável.
- Estado das VMs: anote quais máquinas virtuais dependiam do datastore e se alguma está com snapshot ativo ou em execução.
- Registro de mudanças recentes: atualização de firmware, troca de switch, alteração de zoneamento ou configuração de rede são pistas valiosas.
Ações que agravam a falha e devem ser evitadas
- Não remova o datastore do inventário enquanto houver chance de o caminho voltar.
- Não recrie a assinatura do VMFS nem formate o volume para “testar”.
- Não recrie o LUN no storage com o mesmo nome ou tamanho antes de esgotar o diagnóstico.
- Não execute rescans em massa sem registrar o estado anterior dos caminhos.
- Não desligue o host antes de coletar logs e evidências, pois memória e estado de I/O podem se perder.
- Não restaure backup por cima do volume original sem confirmar que o datastore está realmente perdido.
Diagnóstico por camada: do caminho físico ao VMFS
O datastore inacessível é um sintoma que pode ter origem em camadas muito diferentes. O diagnóstico eficiente segue uma ordem: primeiro o que é barato e reversível de verificar, depois o que exige intervenção. Pular direto para “o VMFS corrompeu” sem descartar falha de rede ou de RAID é o erro mais caro nesse processo.
Conectividade iSCSI, NFS e Fibre Channel
Em iSCSI, verifique se o IQN do initiator está correto e se o target está acessível pela rede. Em NFS, confira se o export ainda existe, se as permissões de IP do host estão válidas e se o servidor NFS responde. Em Fibre Channel, valide zoneamento, estado das portas do switch e WWPNs mapeados no array.
Uma falha de caminho não danifica dados. Ela apenas esconde o volume. Por isso, essa camada deve ser totalmente descartada antes de qualquer suspeita sobre o VMFS. Se o problema for apenas de conectividade, a correção é rápida e sem perda.
Saúde do storage array e do RAID subjacente
O datastore é construído sobre um LUN que, por sua vez, depende de um RAID. Se o RAID está degradado, em rebuild ou com múltiplos discos fora, o LUN pode desaparecer ou ficar instável. No gerenciamento do array, verifique:
- Estado de cada disco físico e presença de preditivos de falha.
- Status do RAID group: healthy, degraded, rebuilding ou failed.
- Eventos recentes de controladora, como failover ou reinício inesperado.
- Se o LUN foi acidentalmente desmapeado ou colocado offline.
Se o RAID falhou de fato, o datastore não volta com ajuste de configuração. O volume precisa ser reconstruído a partir dos discos, o que é trabalho de recuperação especializada, não de administração do vSphere.
Metadados do VMFS e montagem do volume
Quando caminho e storage estão saudáveis, mas o datastore continua inacessível, a suspeita recai sobre os metadados do VMFS. O VMFS mantém estruturas internas que mapeiam arquivos, diretórios e blocos. Se essa estrutura for corrompida por desligamento abrupto, escrita parcial ou ação indevida, o ESXi pode não conseguir montar o volume mesmo vendo o LUN.
Nesse ponto, a investigação exige leitura em baixo nível do volume, análise das estruturas do sistema de arquivos e, frequentemente, trabalho fora do ambiente de produção. É aqui que a diferença entre um administrador e um especialista em recuperação fica evidente: o administrador monta volumes íntegros; o especialista reconstrói volumes danificados.

Quando a correção no vSphere resolve e quando é preciso recuperação especializada
A decisão entre corrigir no vSphere e contratar recuperação especializada depende de onde está a falha. Se o problema é de caminho, zoneamento, permissão NFS ou IQN, a correção é administrativa e resolve no próprio ambiente. Se o problema é de RAID falho, metadados corrompidos ou LUN recriado por engano, a intervenção no vSphere não resolve e pode piorar.
Critérios objetivos para decidir:
- O LUN aparece no storage e está saudável? Se sim, o problema provavelmente é de caminho ou configuração.
- O RAID está íntegro? Se não, a recuperação começa nos discos, não no vSphere.
- O datastore aparece no inventário, mas não monta? Suspeite de metadados do VMFS.
- Houve ação administrativa sobre o volume (recriação, formatação, remoção)? A recuperação precisa desfazer ou contornar essa ação.
- As VMs críticas têm backup íntegro e testado? Se sim, restaurar pode ser mais rápido que recuperar. Se não, a recuperação do datastore é o único caminho.
Um caso típico de recuperação especializada é o datastore que some após um duplo failover de controladora com escrita parcial nos metadados. O volume aparece, mas o ESXi não monta. Outro é o LUN recriado por engano durante uma manutenção: o VMFS original ainda existe nos discos, mas o mapeamento foi perdido. Em ambos, o trabalho é de laboratório, com leitura dos discos e reconstrução das estruturas.
Se o datastore contém VMs com bancos de dados, sistemas de gestão ou arquivos jurídicos, a perda não é apenas operacional: é jurídica e financeira. Nesses casos, a decisão de tentar “consertar sozinho” precisa levar em conta o risco de sobrescrever a única cópia dos dados. A Security Recovery atua exatamente nesse cenário, com laboratório próprio e sala limpa ISO-5 Classe 100 para recuperação de storages corporativos e máquinas virtuais VMware. Quando o datastore não monta e o backup não existe ou está desatualizado, a recuperação especializada é o caminho.
O que define o custo e o prazo de uma recuperação de datastore
O custo e o prazo de uma recuperação de datastore não são fixos: dependem de fatores que só se revelam durante o diagnóstico. Entender esses fatores ajuda a avaliar propostas e a não cair em promessas irreais.
Os principais fatores são:
- Nível da falha: problema de caminho se resolve em horas; RAID com múltiplos discos fora exige reconstrução física e pode levar dias.
- Estado dos metadados do VMFS: quanto mais íntegra a estrutura, mais rápida a reconstrução.
- Existência de sobrescrita: se alguém tentou recriar o LUN ou formatar o volume, a recuperação fica mais complexa.
- Quantidade de VMs e snapshots: snapshots encadeados e discos grandes aumentam o trabalho de validação.
- Necessidade de peças ou doação de discos: em falha física, pode ser preciso localizar componentes compatíveis.
- Urgência do ambiente: recuperação com operação parada costuma ter prioridade e prazo diferenciado.
O prazo também depende de o volume estar em um storage com discos acessíveis ou exigir trabalho em sala limpa. A Security Recovery trabalha com laboratório próprio e equipamentos como PC-3000, DeepSpar e MRT para leitura de mídias danificadas. O diagnóstico inicial define o cenário e permite estimar o esforço com base em evidências, não em suposições.
Prevenção: como reduzir o risco de datastore inacessível
Nenhuma configuração elimina o risco de datastore inacessível, mas um ambiente bem monitorado e com backup independente reduz drasticamente o impacto. A prevenção atua em duas frentes: detectar a falha cedo e ter uma saída quando a falha ocorrer.
Monitoramento de caminhos e alertas de APD
O vSphere gera eventos de APD e PDL que podem ser integrados a ferramentas de monitoramento. Configure alertas para:
- Queda de um ou mais caminhos de storage por mais de alguns segundos.
- Eventos de PDL com sense code específico do array.
- Degradação de RAID reportada pelo gerenciamento do storage.
- Falha de switch ou porta Fibre Channel.
- Alteração não programada de zoneamento ou mapeamento de LUN.
O objetivo é agir na janela de APD, quando o volume ainda está íntegro, em vez de descobrir o problema quando o datastore já está inacessível e as VMs paradas.
Backup independente do storage e testes de restauração
Backup que vive no mesmo storage do datastore não é backup: é uma cópia que morre junto com o volume. A regra de ouro é manter backup em mídia ou sistema independente, fora do array que hospeda o datastore. Além disso, backup sem teste de restauração é apenas esperança.
- Mantenha cópia das VMs críticas em storage separado ou em nuvem.
- Teste a restauração periodicamente, não apenas a execução do backup.
- Documente o procedimento de restauração para o cenário de datastore inteiro perdido.
- Considere replicação para um segundo site se o RTO for curto.
Quando o datastore fica inacessível e o backup existe e foi testado, a recuperação é uma questão de restaurar. Quando o backup não existe, a recuperação especializada é a única saída. A página sobre máquina virtual VMware com datastore corrompido detalha o que ainda é possível recuperar nesse cenário.
Perguntas frequentes
O datastore inacessível significa que perdi todos os dados?
Não. Datastore inacessível significa que o ESXi não consegue montar o volume, não que os dados foram apagados. Em falhas de caminho, o volume volta intacto quando a conectividade é restabelecida. Em falhas de RAID ou metadados, os dados ainda podem existir nos discos, mas exigem recuperação especializada para serem acessados novamente.
Posso reiniciar o host para tentar resolver o datastore inacessível?
Não como primeira ação. Reiniciar o host pode limpar logs e estado de I/O que seriam úteis no diagnóstico. Antes de reiniciar, colete os logs do vmkernel e do hostd, registre o estado dos caminhos e confirme se o evento é APD ou PDL. Se for APD, o ideal é aguardar o caminho voltar antes de qualquer reinicialização.
É seguro recriar a assinatura do VMFS para montar o datastore?
Não. Só deve ser considerada quando o volume original foi confirmadamente perdido e há backup íntegro, e ainda assim com extrema cautela.
Quanto tempo leva para recuperar um datastore inacessível?
O diagnóstico inicial é que define o prazo com base em evidências, não em estimativa genérica.
Quando devo parar de tentar resolver sozinho e chamar um especialista?
Quando o storage e os caminhos estão saudáveis, mas o datastore não monta, ou quando o RAID está degradado a ponto de derrubar o LUN. Também quando houve ação administrativa sobre o volume, como recriação ou formatação. A partir desse ponto, cada tentativa no vSphere aumenta o risco de sobrescrever dados que ainda poderiam ser recuperados.