

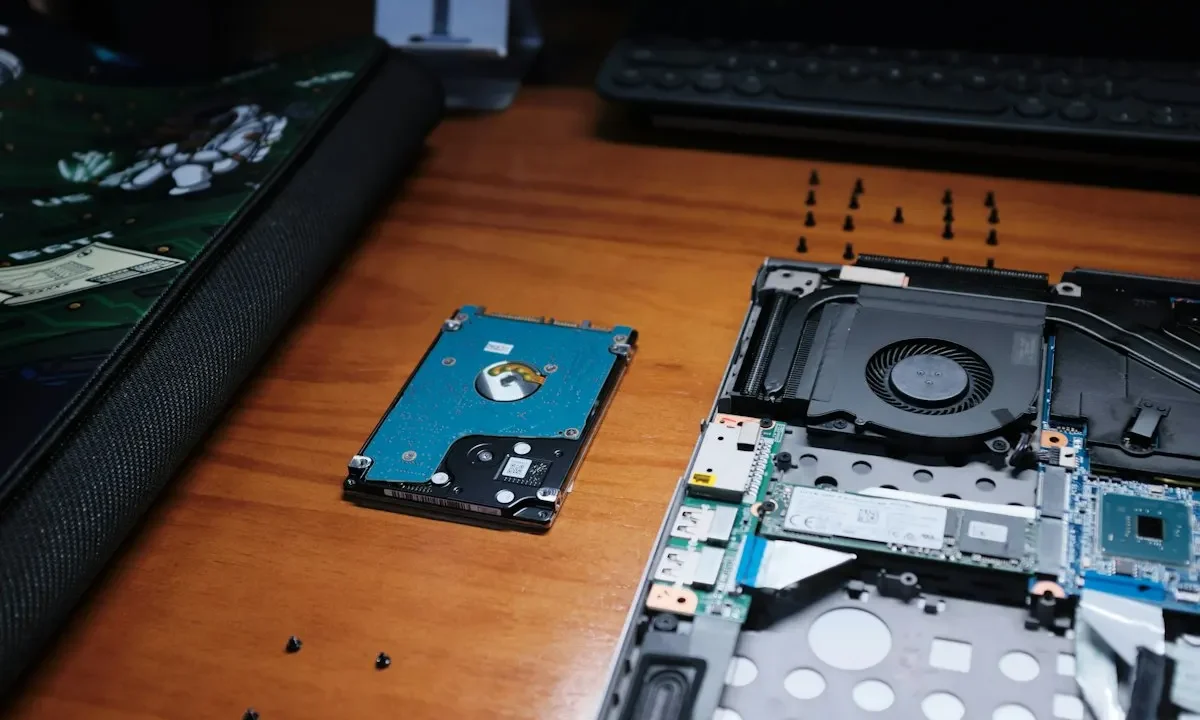

Quando um HD para de responder ou um SSD some do sistema, a reação mais comum é agir rápido — reiniciar, trocar cabos, instalar um utilitário. Só que tentar recuperar sozinho pode piorar um quadro que ainda era reversível, e é justamente essa armadilha que este texto desmonta. Aqui você entende por que as tentativas caseiras costumam custar caro, quais sinais indicam que o caso saiu do seu controle e como agir nas primeiras horas para não perder o que ainda dá para salvar.
Por que a tentativa de resolver sozinho costuma piorar o problema
Quando um HD para de responder, um SSD some do sistema ou um RAID entra em estado degradado, a reação instintiva é agir rápido. O usuário reinicia o computador, troca o cabo, instala um utilitário de verificação ou tenta acessar o dispositivo repetidamente. O que parece diligência, no entanto, é justamente o que transforma uma falha recuperável em perda definitiva. Cada nova tentativa de leitura sobre uma superfície magnética danificada ou sobre células NAND desgastadas adiciona estresse físico e lógico a um componente que já está operando fora das condições de projeto.
O ponto central é que a maioria das falhas não é binária — não existe um momento exato em que os dados “somem”. Existe uma janela em que a mídia ainda contém os arquivos, mas o acesso a eles se torna progressivamente mais difícil. Tentar recuperar sozinho sem entender o modo de falha (elétrico, mecânico, lógico ou de firmware) significa operar às cegas dentro dessa janela. Ações que seriam inofensivas em um dispositivo saudável — como executar um chkdsk ou montar o volume em outro sistema — podem consumir exatamente o tempo de vida restante dos setores ou das cabeças de leitura.
Há ainda um efeito menos óbvio: a contaminação por software. Programas de recuperação caseira gravam dados temporários, atualizam metadados e, em alguns casos, tentam “corrigir” estruturas que interpretam como corrompidas. Em uma mídia com falha física, essa escrita adicional pode sobrescrever justamente as trilhas onde os arquivos originais ainda estavam íntegros. Por isso o conselho técnico é sempre o mesmo: interromper novas tentativas, desligar o dispositivo e buscar diagnóstico antes de qualquer manipulação.
Os erros mais comuns de quem tenta recuperar por conta própria
Os erros amadores seguem um padrão previsível, independentemente do tipo de mídia. Eles costumam nascer da pressa e da crença de que “só mais uma tentativa” vai resolver. A gravidade varia, mas todos têm um traço em comum: reduzem a probabilidade de recuperação profissional posterior. Conhecer esses erros é a primeira forma de evitá-los.
Continuar usando o dispositivo ou a área afetada após a falha
O erro mais destrutivo é manter o dispositivo ligado e em uso depois do primeiro sinal de problema. Em um HD com cabeças de leitura em colapso, cada rotação adicional do prato pode arranhar a superfície e transformar setores ilegíveis em dano físico permanente. Em um SSD, continuar gravando acelera o desgaste das células e dispara processos internos de garbage collection que reescrevem blocos e dificultam a reconstrução lógica dos arquivos.
Em RAID, o erro equivalente é continuar operando o volume após a queda de um disco. Arrays RAID 5 e RAID 6 toleram a perda de um ou dois membros, mas cada hora de operação degradada aumenta a chance de um segundo disco falhar durante a reconstrução — cenário que costuma inviabilizar a recuperação sem intervenção em laboratório. O mesmo vale para NAS e storages: deixar o equipamento ligado “só para copiar mais um arquivo” é exatamente o que não se deve fazer.
Instalar programas e aplicar soluções improvisadas sem diagnóstico
Baixar um software de recuperação e executá-lo diretamente sobre a mídia defeituosa é um dos caminhos mais rápidos para a perda definitiva. Essas ferramentas fazem varreduras intensivas que, em um HD com falha mecânica, forçam as cabeças a percorrer áreas danificadas repetidamente. Em um SSD com firmware corrompido, a varredura pode disparar comandos que o controlador interpreta de forma imprevisível, agravando o estado lógico do dispositivo.
Há também as “soluções” de fórum: congelar o HD, abrir a tampa para “destravar” o motor, trocar a placa lógica por outra de um modelo parecido. Todas ignoram que HDs modernos têm calibração individual por unidade — a placa de um disco não funciona em outro sem a transferência do firmware adaptativo. Abrir a tampa fora de um ambiente controlado expõe os pratos a partículas de poeira que são centenas de vezes maiores que a distância de voo das cabeças. O resultado é quase sempre um disco irrecuperável.
Insistir no mesmo procedimento que já falhou várias vezes
A repetição é um multiplicador de dano. Se o sistema operacional não reconheceu o HD na primeira tentativa, a décima tentativa não vai mudar o diagnóstico — vai apenas acumular estresse sobre o componente. O mesmo vale para o usuário que executa o mesmo utilitário de reparo três, quatro, cinco vezes, ou que reinicia o servidor repetidamente esperando o RAID “voltar sozinho”.
Esse comportamento é especialmente perigoso em falhas intermitentes. Um HD externo que desconecta sozinho, por exemplo, pode estar com problema na controladora USB ou nas cabeças. Cada reconexão força o disco a reiniciar a sequência de spin-up e calibração — e, se a causa for mecânica, cada ciclo aproxima o componente do travamento total. A regra prática é simples: duas tentativas idênticas sem resultado diferente significam que é hora de parar, não de insistir.
O que acontece tecnicamente quando se força a recuperação
Forçar a recuperação não é uma metáfora: é um processo físico e lógico mensurável. Em um HD magnético, os dados vivem em setores gravados sobre pratos que giram a milhares de rotações por minuto. As cabeças de leitura voam sobre essa superfície a uma distância na casa dos nanômetros — menor que uma partícula de fumaça. Quando uma cabeça toca o prato, o atrito arranca material magnético e gera calor. Uma única arranhadura pode destruir milhares de setores em frações de segundo.
Em SSDs, o mecanismo é diferente, mas igualmente irreversível. As células NAND têm um número finito de ciclos de escrita. Quando o firmware entra em estado de falha, ele pode disparar operações internas de manutenção que reescrevem dados em segundo plano. Quanto mais tempo o SSD fica ligado e quanto mais comandos recebe, mais células são consumidas. Há casos em que o controlador entra em modo de proteção e “congela” o dispositivo — e a tentativa de forçar leitura nesse estado pode corromper a tabela de tradução de endereços, que é o mapa que diz onde cada arquivo está fisicamente gravado.
Em bancos de dados e máquinas virtuais, forçar a recuperação significa executar reparos automáticos sobre estruturas que já estão inconsistentes. Um repair mal-sucedido em MySQL ou SQL Server pode truncar tabelas, descartar logs de transação ou recriar índices sobre dados incompletos. Em VMware, tentar ligar uma VM com arquivos .vmdk corrompidos pode gerar snapshots inconsistentes que se propagam para os discos virtuais. O dano deixa de ser apenas no hardware e passa a ser na própria integridade lógica dos dados.
Sinais de que o caso já passou do ponto de resolver sozinho
Existem indicadores objetivos de que a intervenção amadora não tem mais espaço. O primeiro é o ruído: cliques, batidas ou rangidos vindos do HD indicam falha mecânica nas cabeças ou no motor. Nenhum software resolve isso — e cada segundo de rotação agrava o quadro. O segundo é o não reconhecimento na BIOS ou no gerenciador de discos. Quando o dispositivo nem sequer aparece para o sistema, o problema está abaixo da camada lógica: firmware, eletrônica ou mecânica.
Outros sinais incluem:
- HD girando e parando em loop, sem estabilizar a rotação
- SSD detectado com capacidade errada (ex.: 0 GB ou 2 TB em um disco de 1 TB)
- RAID com dois ou mais discos marcados como failed ou offline
- Arquivos que somem e reaparecem entre reinicializações
- Cheiro de queimado ou aquecimento anormal na controladora
- Sistema de arquivos que alterna entre RAW e NTFS sem intervenção
Se qualquer um desses sintomas estiver presente, o cenário já exige diagnóstico em ambiente controlado. A insistência em “tentar mais uma vez” não é perseverança — é consumo da janela de recuperação que ainda resta.
O que fazer nas primeiras horas para não perder o que ainda dá para salvar
As primeiras horas após a falha são as mais decisivas. A prioridade absoluta é interromper qualquer operação de leitura ou escrita sobre o dispositivo. Desligue o equipamento de forma limpa, se possível, e desconecte a mídia da energia. Não reinicie para “ver se volta”, não execute verificações de disco e não tente copiar arquivos “só os mais importantes”. Cada uma dessas ações escreve dados novos ou força leitura sobre áreas comprometidas.
O segundo passo é documentar o que aconteceu. Anote quando a falha começou, quais sintomas apareceram, o que foi tentado até agora e qual é o conteúdo crítico que precisa ser recuperado. Essa informação orienta o diagnóstico e evita que o técnico repita procedimentos que já agravaram o caso. Em ambientes corporativos, registre também quem teve acesso ao dispositivo e se houve tentativa de rebuild em RAID.
O terceiro passo é decidir sobre o destino do dispositivo. Se a falha for lógica — como um HD externo corrompido e ilegível que ainda é reconhecido pelo sistema —, há mais margem para avaliação remota. Se for mecânica, elétrica ou de firmware, o dispositivo não deve ser religado. Em ambos os casos, a regra é a mesma: quanto menos o dispositivo for manipulado antes do diagnóstico, maior a chance de recuperação.
Quando procurar ajuda profissional e o que esperar do atendimento
O momento de procurar ajuda é imediatamente após a interrupção das tentativas caseiras — não depois que elas falharem por completo. Um laboratório especializado trabalha com a mídia em estado passivo: o dispositivo é avaliado sem que o sistema operacional tente montá-lo, sem varreduras destrutivas e sem escrita sobre a área afetada. A primeira etapa é o diagnóstico, que identifica o modo de falha e estima a viabilidade de recuperação.
O que o profissional faz que o usuário não consegue reproduzir em casa inclui:
- Leitura por imagem bit a bit, sem depender do sistema de arquivos original
- Substituição de cabeças de leitura em sala limpa com controle de partículas
- Transferência de firmware adaptativo entre placas lógicas do mesmo modelo
- Reconstrução manual de tabelas de partição e estruturas de diretórios
- Recomposição de RAID a partir de discos individuais, sem rebuild destrutivo
- Extração de dados de SSDs com controlador em estado de falha
Um atendimento sério começa com perguntas, não com promessas. O técnico vai querer saber o histórico da falha, o que foi tentado e qual é a criticidade dos dados. Em seguida, apresenta um diagnóstico com probabilidade de sucesso — nunca uma garantia de 100%, porque nenhum caso é recuperável por completo até que a mídia seja aberta e avaliada. O sigilo também faz parte do processo: contratos de confidencialidade são padrão em casos corporativos, jurídicos e médicos.
Para quem está em São Paulo, vale consultar opções de recuperação de HD externo em São Paulo ou de recuperação de SSD NVMe em São Paulo. Para quem está fora da capital, muitos laboratórios atendem via envio seguro, com protocolo de embalagem antiestática e rastreamento.
O que define o custo de um serviço de recuperação
O custo de uma recuperação profissional não é tabelado por tipo de mídia — ele é definido pelo diagnóstico técnico do caso. Três fatores pesam mais: o modo de falha, a complexidade da reconstrução lógica e a urgência do atendimento. Uma falha lógica simples, em que o sistema de arquivos está corrompido mas a mídia está fisicamente íntegra, tende a custar menos porque não exige abertura do dispositivo nem peças doadoras.
Casos mecânicos — como um HD com cabeças danificadas — envolvem a aquisição de um disco doador compatível, a troca das cabeças em sala limpa e a leitura por imagem. Isso eleva o custo porque exige infraestrutura especializada e tempo de bancada. O mesmo vale para RAIDs complexos: recompor um RAID 5 com um disco fora de sincronia é mais trabalhoso do que recuperar um volume simples, e a complexidade se reflete no preço.
A urgência também influencia. Um atendimento prioritário, com equipe dedicada e prazo reduzido, custa mais do que um atendimento padrão. Por isso, muitos laboratórios oferecem avaliação inicial sem custo, em que o cliente descobre o diagnóstico e o orçamento antes de autorizar o serviço. Esse modelo existe justamente para que a decisão seja tomada com base em fatos técnicos, não em suposições.
Como evitar que o problema volte a acontecer
A prevenção real não está em um software milagroso, e sim em uma política de redundância. A regra mais citada por especialistas é a do backup 3-2-1: três cópias dos dados, em dois tipos de mídia diferentes, com uma cópia fora do local físico. Para empresas, isso significa backup automatizado com verificação periódica de restauração — porque um backup que nunca foi testado não é um backup, é uma esperança.
Além do backup, há medidas de monitoramento que reduzem a chance de falha silenciosa:
- Usar ferramentas que leem os atributos SMART de HDs e SSDs regularmente
- Substituir discos que apresentam setores realocados em crescimento
- Manter RAID com hot spare e alertas configurados para queda de disco
- Proteger servidores e storages com nobreak e aterramento adequado
- Evitar desligamentos abruptos durante gravações em bancos de dados
- Revisar a integridade de backups ao menos uma vez por trimestre
Para quem já passou por uma perda, a lição mais valiosa é reconhecer os sinais cedo. Um HD com falha raramente para de funcionar sem aviso: ruídos, lentidão anormal, arquivos que somem e mensagens de erro são alertas que antecedem o colapso. Agir nesses sinais — fazendo backup imediato e interrompendo o uso — é o que separa um susto de uma perda definitiva.
O mesmo princípio vale para a recuperação em si: saber quando parar de tentar resolver sozinho é o que preserva a janela de recuperação. Quanto mais cedo o dispositivo sai das mãos do usuário e entra em um fluxo de diagnóstico passivo, maior a probabilidade de os dados voltarem íntegros. A recuperação de dados não é uma loteria — é uma corrida contra o dano progressivo, e cada tentativa amadora entrega vantagem ao lado errado.





