

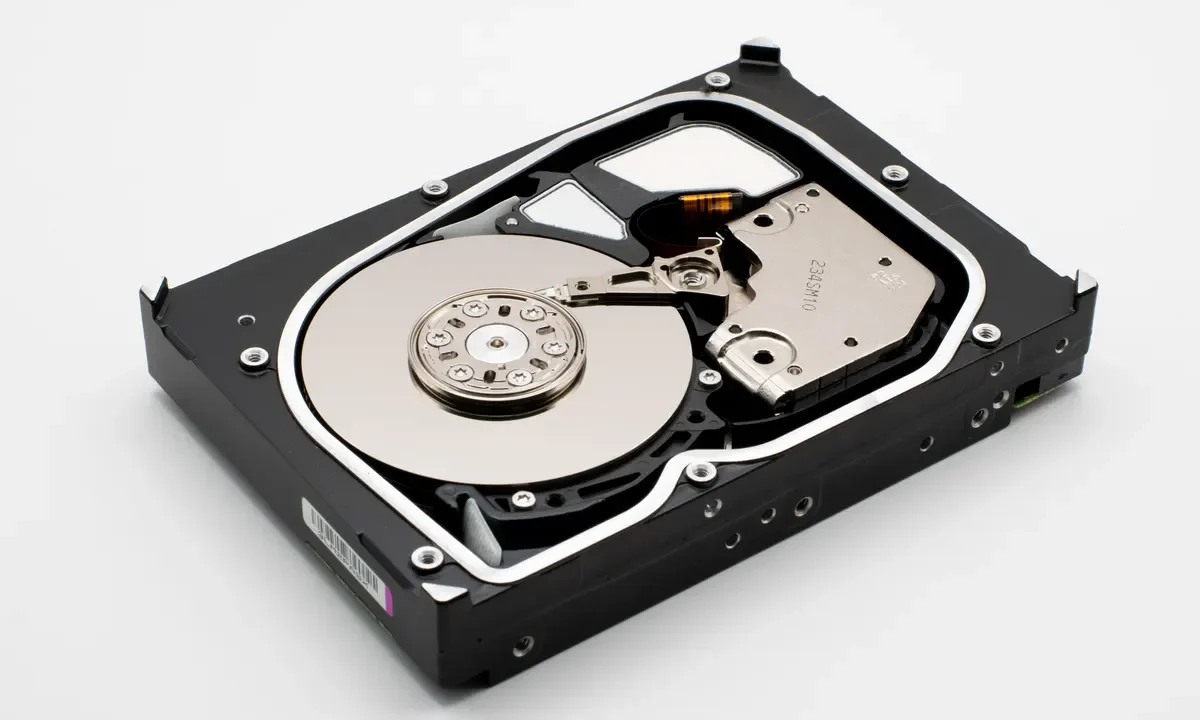

O NAS Buffalo que guardava seus arquivos parou de responder, sumiu da rede ou não monta mais o volume — e agora você precisa decidir o que fazer antes que a situação piore. Entre tentar manobras em casa e enviar o equipamento para um laboratório, cada escolha errada pode custar caro. Este texto ajuda você a recuperar dados de NAS Buffalo: mostra como identificar a camada da falha, o que é seguro tentar, o que nunca fazer e quando parar.
O que é um NAS Buffalo e por que ele para de funcionar
Um NAS Buffalo é um dispositivo de armazenamento conectado à rede que centraliza arquivos, backups e mídia para acesso simultâneo por computadores, celulares e TVs. Diferente de um HD externo plugado por USB, o NAS opera como um pequeno servidor com sistema operacional próprio, processador, memória RAM e um ou mais discos internos. Quando ele falha, o impacto costuma ser maior: não é apenas um arquivo que some, mas um volume inteiro que deixa de montar, um compartilhamento que desaparece da rede ou o próprio aparelho que para de ligar.
As causas de falha em um NAS Buffalo se dividem em três camadas. A primeira é elétrica e eletrônica — fonte queimada, placa-mãe com capacitor estourado, controladora SATA defeituosa. A segunda é mecânica e de disco — setores defeituosos, cabeça de leitura danificada, motor que não gira mais. A terceira é lógica e de arranjo — corrupção do sistema de arquivos, falha na tabela de RAID, volume que perdeu consistência após queda de energia. Em muitos casos atendidos por laboratórios, duas ou três camadas falham ao mesmo tempo, o que exige diagnóstico em etapas.
LinkStation, TeraStation e os modelos mais comuns no Brasil
A Buffalo fabrica duas linhas principais de NAS. A LinkStation é a linha doméstica e de pequeno escritório, com um ou dois discos, voltada para backup de fotos, documentos e mídia. A TeraStation é a linha corporativa e de departamento, com quatro, seis ou oito baias, suporte a RAID 5, 6 e 10, fontes redundantes em alguns modelos e recursos como replicação entre unidades e integração com Active Directory.
No Brasil circulam muitos modelos das séries LinkStation LS-400, LS-500 e LS-700, além das TeraStation TS-3000, TS-5000 e TS-6000. Alguns aparelhos mais antigos, como LinkStation LS-CHL e TeraStation TS-XL, ainda aparecem em escritórios de contabilidade, clínicas e pequenas indústrias que mantêm o equipamento original por anos. A idade do aparelho importa no diagnóstico: modelos com mais de oito ou dez anos concentram falhas de fonte e de placa-mãe, enquanto unidades mais novas tendem a apresentar primeiro degradação de disco e corrupção de volume.
Como o NAS guarda seus dados: volumes, RAID e sistema de arquivos XFS
Internamente, o NAS Buffalo não grava arquivos como um HD externo comum. Ele organiza os discos em um arranjo RAID, cria volumes lógicos sobre esse arranjo e formata o volume com um sistema de arquivos — na grande maioria dos modelos Buffalo, o XFS. É o XFS que registra onde cada arquivo começa e termina, quais blocos estão livres e qual a estrutura de diretórios. Quando esse sistema de arquivos corrompe, o volume pode até aparecer na interface, mas os dados ficam inacessíveis ou a montagem falha.
O RAID adiciona uma camada de complexidade. Em um RAID 1 (espelhamento), cada disco tem uma cópia completa dos dados. Em um RAID 5, os dados e a paridade são distribuídos entre três ou mais discos, e o arranjo tolera a perda de um disco. Em um RAID 6, tolera dois. O problema é que a tolerância do RAID não é recuperação: quando um disco falha e o usuário ou o próprio sistema tenta reconstruir o arranjo, discos remanescentes com setores defeituosos podem derrubar a reconstrução e corromper o volume inteiro.
Diagnóstico rápido: o NAS não liga, não aparece na rede ou não monta o volume
O primeiro passo diante de um NAS Buffalo com problema é identificar em qual camada a falha está. Um aparelho que não liga aponta para fonte ou placa-mãe. Um aparelho que liga, mas não aparece na rede, sugere falha de configuração, de placa de rede ou de sistema operacional interno. Um aparelho que aparece na rede, mas não monta o volume, indica problema de disco, de RAID ou de sistema de arquivos. Cada cenário exige uma conduta diferente, e errar a camada leva a manobras que pioram o quadro.
O diagnóstico por sintoma é mais confiável do que o diagnóstico por suposição. Antes de abrir o aparelho ou remover discos, vale registrar exatamente o que acontece: quais LEDs acendem, que cor e ritmo eles exibem, se há bipes, se o cooler gira, se o aparelho aparece no roteador com IP fixo ou via DHCP. Esse registro é o que um técnico ou laboratório vai pedir na primeira conversa, e ele evita que o caso seja tratado às cegas.
Sintomas de falha de fonte, placa-mãe e controladora
Fonte defeituosa é a causa mais comum de NAS que não liga, especialmente em aparelhos com mais de cinco anos. Os sintomas típicos incluem: nenhum LED acende, o aparelho não responde ao botão de energia, ou ele liga por alguns segundos e desliga sozinho. Em modelos TeraStation com fonte redundante, uma das fontes pode falhar silenciosamente enquanto a outra assume — o aparelho continua funcionando até a segunda fonte também falhar, aí o desligamento é abrupto e sem aviso.
Placa-mãe com defeito costuma apresentar sintomas diferentes: LEDs acendem parcialmente, o cooler gira, mas o aparelho não conclui o boot, não emite bip de inicialização ou não aparece na rede. Controladora SATA defeituosa, por sua vez, pode fazer o NAS ligar normalmente e até exibir a interface web, mas os discos não são detectados — o volume aparece como ausente ou vazio. Nesses casos, os discos em si podem estar íntegros, e a recuperação passa por ler os discos fora do aparelho, não por consertar a controladora.
Sintomas de falha de disco e de degradação de RAID
Falha de disco em NAS Buffalo se manifesta de formas variadas. O volume pode montar, mas a leitura de alguns arquivos trava ou retorna erro de E/S. A interface web pode exibir o disco como “degraded” ou “failed”. O acesso via SMB fica lento, arquivos somem de pastas ou a cópia de um arquivo grande interrompe no meio. Em RAID 5 ou 6, a falha de um disco coloca o arranjo em modo degradado, e o NAS passa a operar sem redundância — qualquer novo erro de leitura em outro disco vira risco imediato de perda total.
A degradação de RAID nem sempre é anunciada. Muitos usuários só percebem o problema quando o segundo disco falha ou quando uma reconstrução automática trava. Um disco com contagem crescente de setores realocados, erros de leitura pendentes ou temperatura acima do normal está pedindo substituição — e o momento de substituir é antes da reconstrução, não depois dela.
Como ler os LEDs e os bipes de erro do seu modelo
Os LEDs do painel frontal são o primeiro código de diagnóstico que o NAS Buffalo oferece. Em geral, LED de energia aceso e estável indica que o aparelho ligou; piscando em ritmo constante, indica boot em andamento; piscando rápido ou alternando cores, indica erro. O LED de cada disco costuma ter três estados: aceso (disco presente e saudável), piscando (atividade de leitura/escrita) e vermelho ou âmbar (falha ou disco ausente). A combinação exata varia por modelo, e o manual da série LinkStation ou TeraStation traz a tabela de códigos.
Os bipes seguem a mesma lógica. Um bip curto na inicialização costuma indicar boot normal. Bipes contínuos ou sequências repetidas indicam falha de hardware, de memória ou de disco. Em alguns modelos TeraStation, uma sequência específica de bipes acompanha a falha de um disco ou a queda de um arranjo RAID. Registrar a cor, o ritmo e a sequência dos LEDs e bipes antes de desligar o aparelho é informação que acelera o diagnóstico em laboratório e evita que o técnico precise reproduzir a falha do zero.
O que você pode tentar antes de qualquer coisa arriscada
Há uma faixa estreita de ações seguras que o próprio usuário pode executar antes de recorrer a um laboratório. Elas se resumem a verificar, não a alterar: reiniciar de forma controlada, acessar a interface web para ler o status, testar o acesso por protocolos diferentes. Nenhuma dessas ações modifica os discos. O que modifica os discos — reconstruir RAID, formatar, rodar ferramenta de reparo — fica de fora dessa faixa e será tratado na sequência.
A regra prática é simples: se a ação que você está considerando grava dados nos discos, ela não é segura. Se ela apenas lê, pode ser tentada com cautela. Essa distinção evita o erro mais comum em casos de NAS Buffalo, que é transformar uma falha recuperável em perda definitiva por excesso de tentativa.
Reinicialização segura e verificação pela interface web
Um NAS Buffalo travado pode, em alguns casos, voltar ao normal com um desligamento controlado. O procedimento correto é manter o botão de energia pressionado por alguns segundos até o aparelho desligar, aguardar alguns minutos e religar. Isso resolve travamentos de sistema operacional interno, mas não resolve falha de disco nem corrupção de volume. Se o aparelho voltar a travar logo após a reinicialização, o problema é físico ou lógico, não de travamento pontual.
Com o NAS ligado, a interface web — acessível pelo endereço IP do aparelho no navegador — é a melhor fonte de informação. Ela mostra o status de cada disco, a saúde do RAID, a temperatura, o espaço livre e os logs de erro. Vale ler atentamente a seção de armazenamento e os logs antes de qualquer outra ação. Um volume marcado como “degraded” ou um disco com status “failed” na interface já é motivo para interromper novas tentativas e buscar diagnóstico especializado, não para tentar corrigir pela própria interface.
Acesso por SMB, FTP e SSH: o que ainda dá para acessar
Se o NAS aparece na rede mas o volume não monta pelo explorador de arquivos, testar outros protocolos ajuda a mapear o problema. O acesso SMB (compartilhamento de rede do Windows) pode falhar por problema de permissão ou de configuração, enquanto o FTP pode continuar funcionando. Em modelos que permitem habilitar SSH, o acesso por terminal mostra os discos, as partições e o estado do sistema de arquivos com precisão muito maior do que a interface gráfica.
O que se procura nesses testes é delimitar a falha. Se o FTP lista os arquivos mas o SMB não monta, o problema pode ser de configuração de compartilhamento, não de dados. Se o SSH mostra os discos e as partições, mas o volume não monta, o problema está no sistema de arquivos ou no RAID. Nenhum desses testes deve incluir comandos de reparo, reconstrução ou formatação — apenas leitura e listagem. A tentação de rodar um comando de reparo “rápido” via SSH é exatamente o que transforma casos simples em casos complexos.
O que NÃO fazer: reconstruir RAID, formatar ou trocar discos de posição
Reconstruir o RAID manualmente ou aceitar uma reconstrução automática sem antes copiar os dados é uma das ações mais perigosas. Em um RAID 5 ou 6 degradado, a reconstrução força leitura intensa de todos os discos remanescentes — se um deles tiver setores defeituosos, a reconstrução trava e o volume corrompe. Formatar o volume ou os discos na esperança de “limpar o erro” também é arriscado: formatação apaga a estrutura do sistema de arquivos e, em muitos casos, destrói a tabela de RAID.
Trocar os discos de posição ou remover e recolocar discos fora de ordem é igualmente perigoso. O arranjo RAID depende da ordem física e lógica dos discos; inverter dois discos pode fazer o controlador interpretar o arranjo como inválido e iniciar uma reconstrução destrutiva. O mesmo vale para ligar o NAS sem um dos discos ou com um disco novo no lugar de um com falha. Em cenários assim, o link troquei o disco errado detalha por que a ordem dos discos é crítica e o que fazer quando o erro já aconteceu.
Recuperando os discos fora do NAS Buffalo
Quando o aparelho não liga ou a controladora falhou, a recuperação sai do NAS e vai para os discos. O procedimento padrão em laboratório é remover cada disco, etiquetar a posição original, conectar os discos a um equipamento de leitura e trabalhar com imagens setor a setor. O objetivo nunca é “consertar” o NAS original, e sim extrair os dados de forma controlada e reconstruir o volume em outro ambiente.
Essa etapa exige entender como o Buffalo organiza os dados. A maioria dos modelos usa Linux internamente, com partições formatadas em XFS ou ext4 e, em arranjos com múltiplos discos, camadas de LVM ou RAID por software. Reconhecer essas camadas é o que separa uma recuperação limpa de uma tentativa que corrompe ainda mais o arranjo.
Ler discos de NAS em Linux: XFS, ext4 e LVM
Os discos de um NAS Buffalo não são lidos por Windows ou macOS sem ferramentas específicas. Eles carregam partições Linux, normalmente XFS nos volumes de dados e ext4 em partições de sistema. O XFS, em particular, é robusto, mas quando corrompe, a recuperação exige ferramentas que entendam sua estrutura de journal e de alocação de inodes. Tentar montar um volume XFS corrompido com opções erradas pode agravar a inconsistência.
Em arranjos com múltiplos discos, o LVM (Logical Volume Manager) adiciona outra camada: os discos físicos são combinados em um volume lógico que o sistema enxerga como um único dispositivo. A recuperação precisa primeiro reconstruir a ordem e os metadados do LVM, depois montar o volume lógico, e só então acessar o XFS. Cada camada tem seus próprios pontos de falha, e um erro em qualquer uma delas impede o acesso aos dados mesmo que os discos estejam fisicamente íntegros.
Montagem somente leitura e cópia setor a setor com imagem dos discos
A prática segura em recuperação de NAS é nunca trabalhar diretamente sobre os discos originais. O primeiro passo é criar uma imagem setor a setor de cada disco — uma cópia bit a bit que preserva todos os setores, inclusive os defeituosos e os marcados como ilegíveis. Todo o trabalho de reconstrução de RAID, LVM e sistema de arquivos é feito sobre as imagens, não sobre os discos. Se uma tentativa de montagem corromper a imagem, basta gerar outra a partir do original.
A montagem somente leitura é o complemento dessa prática. Montar um volume com a opção de somente leitura impede que o sistema operacional grave qualquer coisa no sistema de arquivos durante a análise. Isso é essencial porque o simples ato de montar um XFS corrompido pode disparar a recuperação de journal, que grava no volume e altera o estado original. Em casos de RAID degradado, a leitura direta sem imagem prévia é ainda mais arriscada: cada leitura nos discos remanescentes pode encontrar setores defeituosos e agravar a falha física.
Quando o RAID é proprietário e a montagem simples não funciona
Nem todo NAS Buffalo usa RAID por software padrão do Linux. Alguns modelos, especialmente TeraStation mais antigas, implementam arranjos com metadados proprietários ou variações que ferramentas genéricas não reconhecem automaticamente. Nesses casos, a montagem simples dos discos em um Linux comum não funciona: o sistema não identifica o arranjo, não encontra o volume lógico ou monta o XFS com estrutura inconsistente.
Quando isso acontece, a recuperação exige engenharia reversa do arranjo — identificar manualmente a ordem dos discos, o tamanho dos stripes, o posicionamento da paridade e o formato dos metadados. É um trabalho de laboratório que combina análise hexadecimal, conhecimento dos controladores Buffalo e ferramentas específicas de reconstrução de RAID. Para quem enfrenta um arranjo que não monta, o artigo recuperar RAID vale a pena ajuda a decidir entre insistir na reconstrução caseira e partir para a análise profissional.
O que define o custo de uma recuperação de dados em NAS Buffalo
O custo de recuperação de um NAS Buffalo não é tabelado por aparelho, e sim por complexidade do caso. Dois NAS idênticos podem ter custos de recuperação completamente diferentes se um tiver falha lógica simples e o outro tiver dois discos com dano físico e RAID degradado. Entender o que compõe essa complexidade ajuda a avaliar orçamentos e a não cair em promessas vagas.
Três fatores pesam mais: o número de discos e o tipo de arranjo, o estado físico de cada disco, e a natureza da falha — lógica ou física. Há ainda um quarto fator, menos óbvio: o que já foi tentado antes. Um NAS que passou por reconstrução forçada, formatação ou troca de discos fora de ordem chega ao laboratório com o arranjo alterado, o que exige mais etapas de análise e, em alguns casos, reduz as chances de sucesso.
Complexidade do arranjo, número de discos e estado físico
Arranjos com mais discos e paridade distribuída são mais complexos de reconstruir. Um RAID 1 com dois discos exige menos etapas do que um RAID 6 com seis discos, onde a reconstrução depende de calcular a posição exata da paridade dupla. O estado físico de cada disco também pesa: um disco com setores defeituosos exige leitura controlada, possivelmente em equipamento especializado; um disco com cabeça danificada exige abertura em sala limpa e troca de componentes.
O estado físico é, na prática, o fator que mais varia o custo. Discos íntegros com falha apenas lógica podem ser lidos em equipamento comum, gerando imagens rapidamente. Discos com dano mecânico exigem doação de peças, ambiente controlado e leitura setor a setor com múltiplas passadas — um processo lento e delicado. Em arranjos com vários discos, o pior estado físico entre eles define o piso de complexidade do caso inteiro.
O que muda entre recuperação lógica e recuperação física
Recuperação lógica é quando os discos estão fisicamente saudáveis e o problema está na estrutura: RAID corrompido, LVM inconsistente, XFS com journal quebrado, arquivos apagados. O trabalho é feito sobre imagens dos discos, sem abrir os componentes, e o resultado depende de reconstruir corretamente as camadas lógicas. É o cenário mais comum em NAS Buffalo com falha após queda de energia ou reconstrução mal sucedida.
Recuperação física é quando um ou mais discos têm defeito mecânico ou eletrônico: cabeça de leitura danificada, motor que não gira, placa lógica queimada, superfície com riscos. O disco precisa ser aberto em ambiente controlado, ter componentes substituídos e ser lido em equipamento próprio. Em RAID, a recuperação física de um único disco costuma ser suficiente para reconstruir o arranjo — desde que os demais discos estejam íntegros. A combinação de falha física em um disco e falha lógica no arranjo é o caso mais complexo e o que exige mais etapas.
Quando parar de tentar sozinho e procurar um laboratório
Há um ponto em que cada nova tentativa caseira reduz as chances de recuperação. Identificar esse ponto é a decisão mais importante de todo o processo. Ele é marcado por sinais objetivos: ruídos mecânicos, cliques repetidos, superaquecimento, cheiro de queimado, ou a constatação de que o RAID está degradado e qualquer reconstrução é arriscada. A partir daí, o custo de insistir supera em muito o custo de parar.
A regra vale para os dois perfis de usuário. Para a pessoa física com fotos e documentos, cada tentativa de montar o volume corrompido grava no disco e pode sobrescrever justamente o que se quer salvar. Para a empresa com NAS em produção, cada hora de tentativa caseira é hora de parada operacional — e a parada costuma custar mais do que a recuperação. Em ambos os casos, o artigo RAID parou de funcionar detalha as primeiras horas críticas e o que fazer — e não fazer — nesse intervalo.
Sinais de que o disco está morrendo: ruídos, cliques e superaquecimento
Ruído de clique repetido é o sinal mais claro de falha mecânica iminente. O clique indica que a cabeça de leitura não consegue encontrar a trilha de referência e está batendo no batente interno — cada clique é uma tentativa frustrada que pode riscar a superfície do disco. Ruído de grunhido ou zumbido irregular sugere motor com problema. Superaquecimento acima do normal, mesmo com o cooler funcionando, indica atrito interno ou falha elétrica.
Qualquer um desses sinais exige desligamento imediato do NAS. Manter o aparelho ligado com um disco clicando é a forma mais rápida de transformar uma falha de cabeça recuperável em dano de superfície irreversível. O mesmo vale para cheiro de queimado ou fumaça: desligue, desconecte da tomada e não religue. Se o disco parar de clicar sozinho, isso não é bom sinal — pode significar que a cabeça colapsou sobre a superfície.
O que perguntar antes de entregar seu NAS a uma empresa
Antes de enviar um NAS Buffalo para recuperação, algumas perguntas filtram empresas sérias de aventureiros. A primeira é sobre o processo: a empresa trabalha com imagens setor a setor ou mexe direto nos discos originais? A segunda é sobre a estrutura: há ambiente controlado para abertura de discos com dano físico, ou o serviço é apenas lógico? A terceira é sobre o diagnóstico: o orçamento é dado após análise, ou há um valor fechado antes de abrir o aparelho?
Vale perguntar também sobre sigilo e sobre a política de não sucesso. Empresas sérias descrevem o que acontece se o caso não for recuperável — se há cobrança de diagnóstico, se os discos são devolvidos, se os dados são destruídos após a entrega. E vale desconfiar de quem promete recuperação garantida: em recuperação de dados, o resultado depende do estado físico e lógico de cada disco, e nenhum diagnóstico honesto garante 100% de sucesso antes de abrir o caso. Para RAID especificamente, o artigo RAID com dois discos explica os limites do que é tecnicamente possível.
Como evitar perder tudo de novo: backup em NAS Buffalo
Um NAS Buffalo recuperado devolve os dados, mas não devolve a tranquilidade se o backup continuar inexistente. O NAS em si não é backup — é um ponto único de armazenamento que concentra risco. A prevenção real passa por replicar os dados para fora do aparelho, com frequência definida e verificação periódica de que as cópias são íntegras e restauráveis.
Os próprios modelos Buffalo oferecem recursos para isso: replicação entre dois NAS, backup para disco USB externo, integração com serviços de nuvem e agendamento de tarefas. O que falta na maioria dos casos não é recurso, é disciplina. Configurar o backup uma vez e nunca verificar se ele roda é quase tão arriscado quanto não ter backup nenhum.
Backup 3-2-1 aplicado a NAS doméstico e de pequeno escritório
A regra 3-2-1 é o padrão mínimo de proteção: três cópias dos dados, em dois tipos de mídia diferentes, com uma cópia fora do local físico. Aplicada a um NAS Buffalo doméstico, isso significa manter a cópia original no NAS, uma segunda cópia em um HD externo ou segundo NAS, e uma terceira cópia na nuvem ou em um disco guardado em outro endereço. A cópia fora do local protege contra incêndio, furto e surto elétrico que destruam o ambiente inteiro.
Em pequeno escritório, a regra 3-2-1 se aplica com algumas adaptações. A cópia na nuvem pode ser inviável para volumes grandes ou para dados sensíveis com restrição regulatória — nesse caso, a cópia fora do local pode ser um segundo NAS em outro endereço, com replicação agendada. O ponto inegociável é a existência de pelo menos uma cópia que não dependa do NAS principal nem do mesmo ambiente físico. Sem isso, qualquer falha grave do aparelho volta a colocar todos os dados em risco.
Monitoramento de discos, alertas de SMART e substituição preventiva
O monitoramento contínuo é o que transforma falha catastrófica em substituição programada. Os NAS Buffalo leem os atributos SMART de cada disco — contagem de setores realocados, erros de leitura pendentes, horas de uso, temperatura — e podem enviar alertas por e-mail quando um atributo ultrapassa o limite. Configurar esses alertas é a medida preventiva de maior retorno: um disco com setores realocados crescendo avisa com semanas ou meses de antecedência antes de falhar de vez.
A substituição preventiva segue o alerta. O procedimento correto é substituir o disco degradado antes que ele falhe, com o arranjo ainda íntegro e redundante. Em RAID 5, isso significa trocar o disco com alerta enquanto os demais estão saudáveis, deixando a reconstrução acontecer com margem de segurança. A lógica é oposta à da emergência: na emergência, reconstrói-se com discos cansados e sem cópia; na prevenção, reconstrói-se com o arranjo saudável e com backup em dia. Para entender o que fazer quando o alerta já virou falha, o artigo disco piscando vermelho orienta os primeiros passos.





